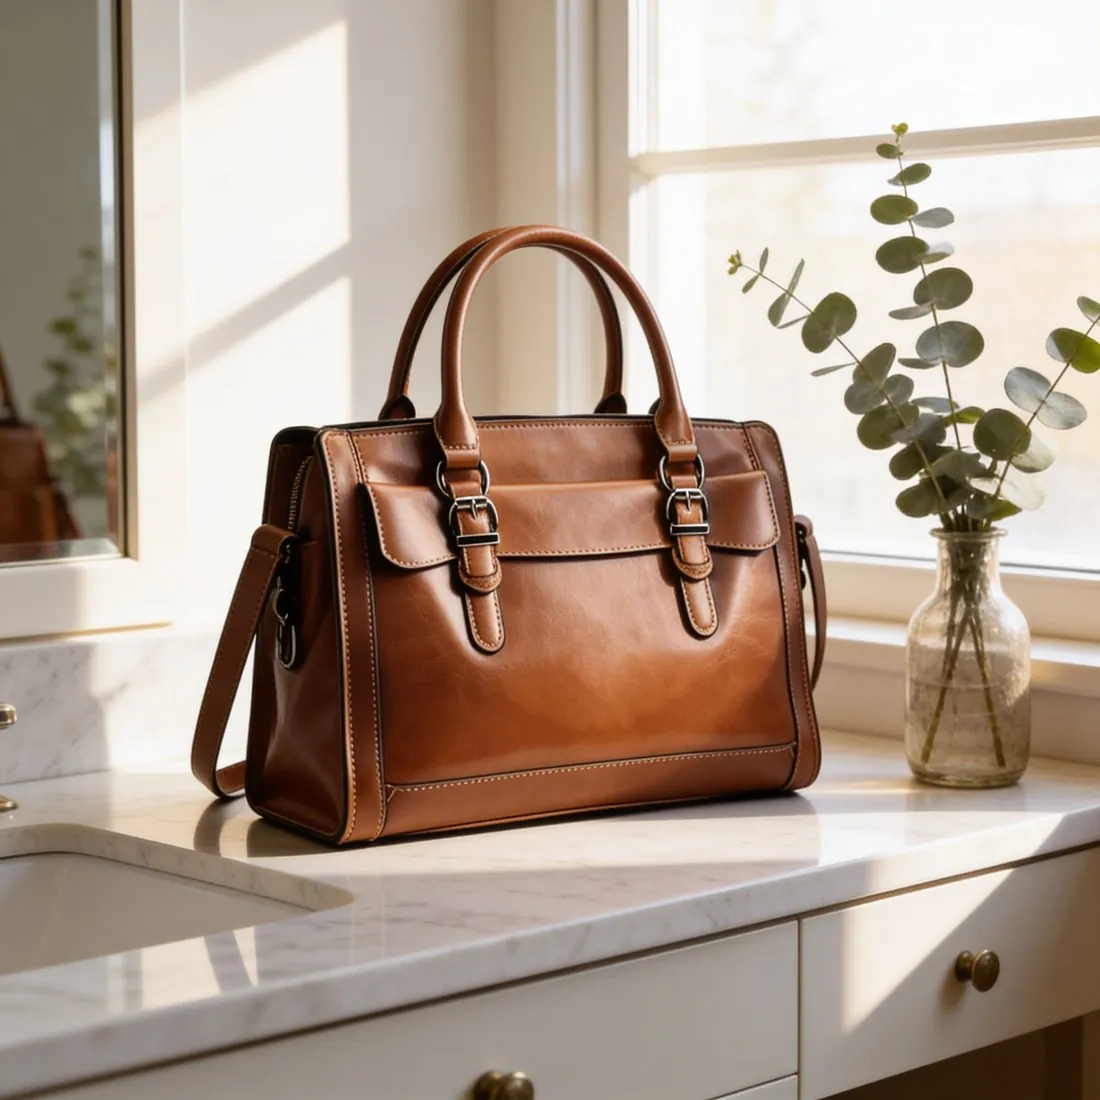
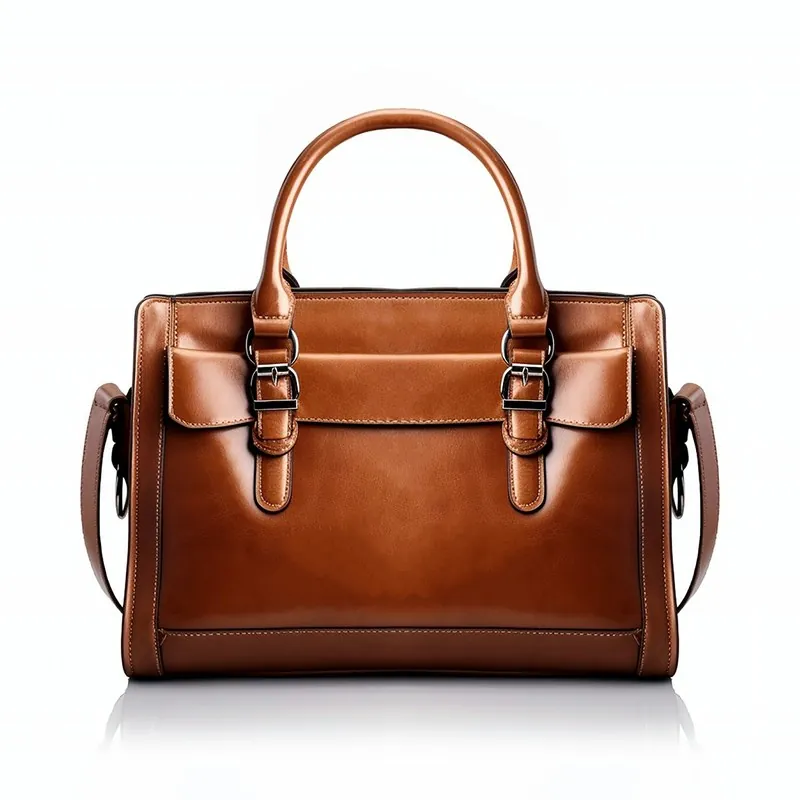
Ein Text-to-Image-Modell verwandelt Wörter in Pixel. Es hat aus sehr großen Sammlungen von Bildern und Bildunterschriften gelernt, wie eine Wendung wie ein Leinenhemd auf einer Steinterrasse in der Abenddämmerung gewöhnlich aussieht, und zeichnet ein neues Bild, das zur Beschreibung passt. Das Ergebnis ist in seiner Anordnung neu, aber aus Mustern gebaut, nicht aus einem bestimmten Gegenstand; es kann daher ein glaubwürdiges Hemd zeigen, nicht aber das Hemd des Händlers.
Das ist die zentrale Grenze für Produktbilder. Ein allein aus Text erzeugtes Produkt ist erfunden: Es weicht in Schnitt, Farbe, Muster, Beschlägen und Etikett vom echten Artikel ab und kann diesen Artikel in einem Angebot nicht vertreten, wie nah es auch aussieht. Viele Marktplätze verlangen, dass Bilder das tatsächliche Produkt zeigen, und mehrere erlauben KI nur für Hintergründe, Szenen oder Models um ein echtes Produktfoto. Auch die Regeln zur Offenlegung und Kennzeichnung von KI-Bildern unterscheiden sich zwischen Marktplätzen.
Text-to-Image eignet sich für das, was keine einzige wahre Form hat: Hintergründe, Requisiten, Stimmungsszenen, Texturen und Muster oder ein Set für eine Kampagne. Für das Produkt selbst ist der verlässliche Weg Image-to-Image, bei dem ein Foto des echten Artikels der Ausgangspunkt ist. Dient eine erzeugte Szene als Hintergrund für einen Freisteller des echten Produkts, müssen Lichtrichtung, Schatten und Perspektive zum Produktfoto passen, sonst wirkt das Produkt eingeklebt.