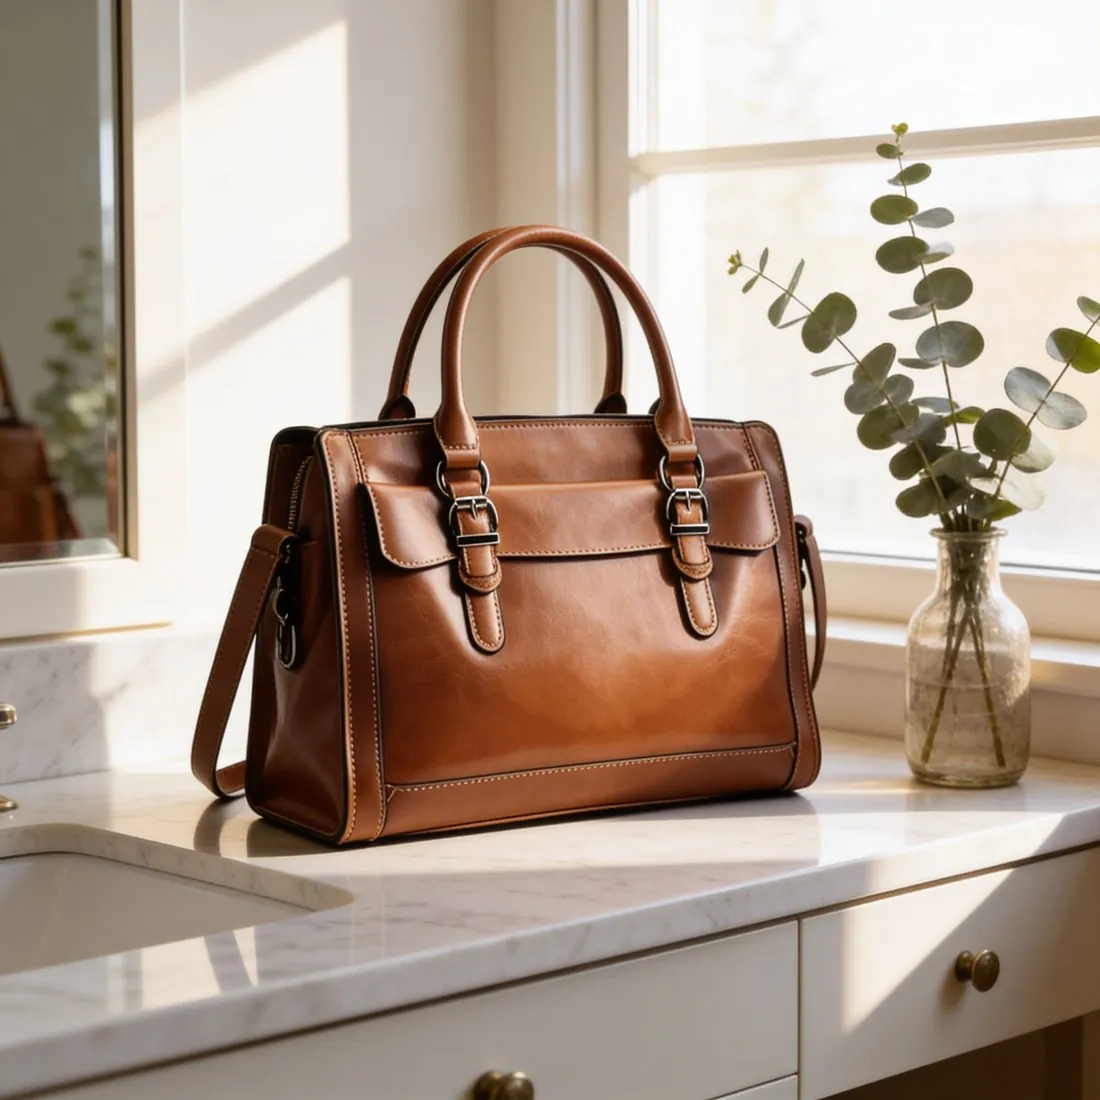
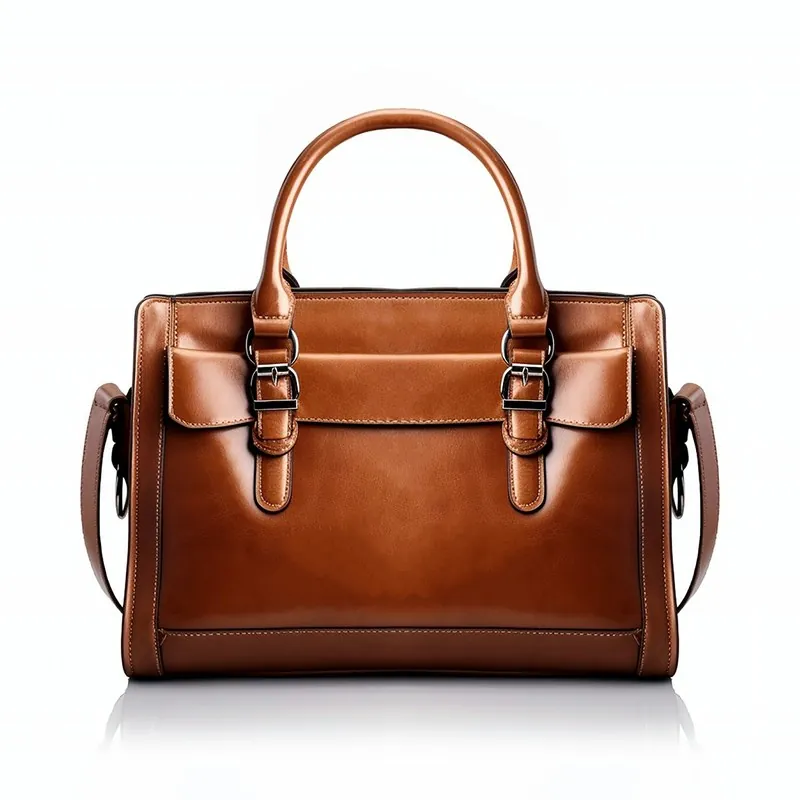
Un modello da testo a immagine trasforma le parole in pixel. Ha imparato, da raccolte molto ampie di immagini e didascalie, che aspetto ha di solito una frase come una camicia di lino su una terrazza di pietra al tramonto, e disegna una nuova immagine che corrisponde alla descrizione. Il risultato è nuovo nella composizione ma costruito su schemi, non su un oggetto preciso, per cui può mostrare una camicia plausibile ma non la camicia del venditore.
È questo il limite centrale per le immagini prodotto. Un prodotto generato solo da un testo è inventato: differisce dall’articolo reale per taglio, colore, fantasia, accessori metallici ed etichetta, e non può rappresentare quell’articolo in un’inserzione, per quanto gli somigli. Molti marketplace richiedono che le immagini mostrino il prodotto effettivo, e diversi ammettono l’IA solo per sfondi, scene o modelli attorno a una foto reale del prodotto. Anche le regole su dichiarazione ed etichettatura delle immagini IA differiscono tra i marketplace.
La generazione da testo a immagine si presta a ciò che non ha un’unica forma vera: sfondi, oggetti di scena, scene d’atmosfera, texture e fantasie, o un set per una campagna. Per il prodotto stesso la via affidabile è quella da immagine a immagine, in cui una foto dell’articolo reale è il punto di partenza. Dove una scena generata fa da sfondo a uno scontorno del prodotto reale, la direzione della luce, le ombre e la prospettiva devono corrispondere alla foto del prodotto, altrimenti il prodotto sembra incollato.