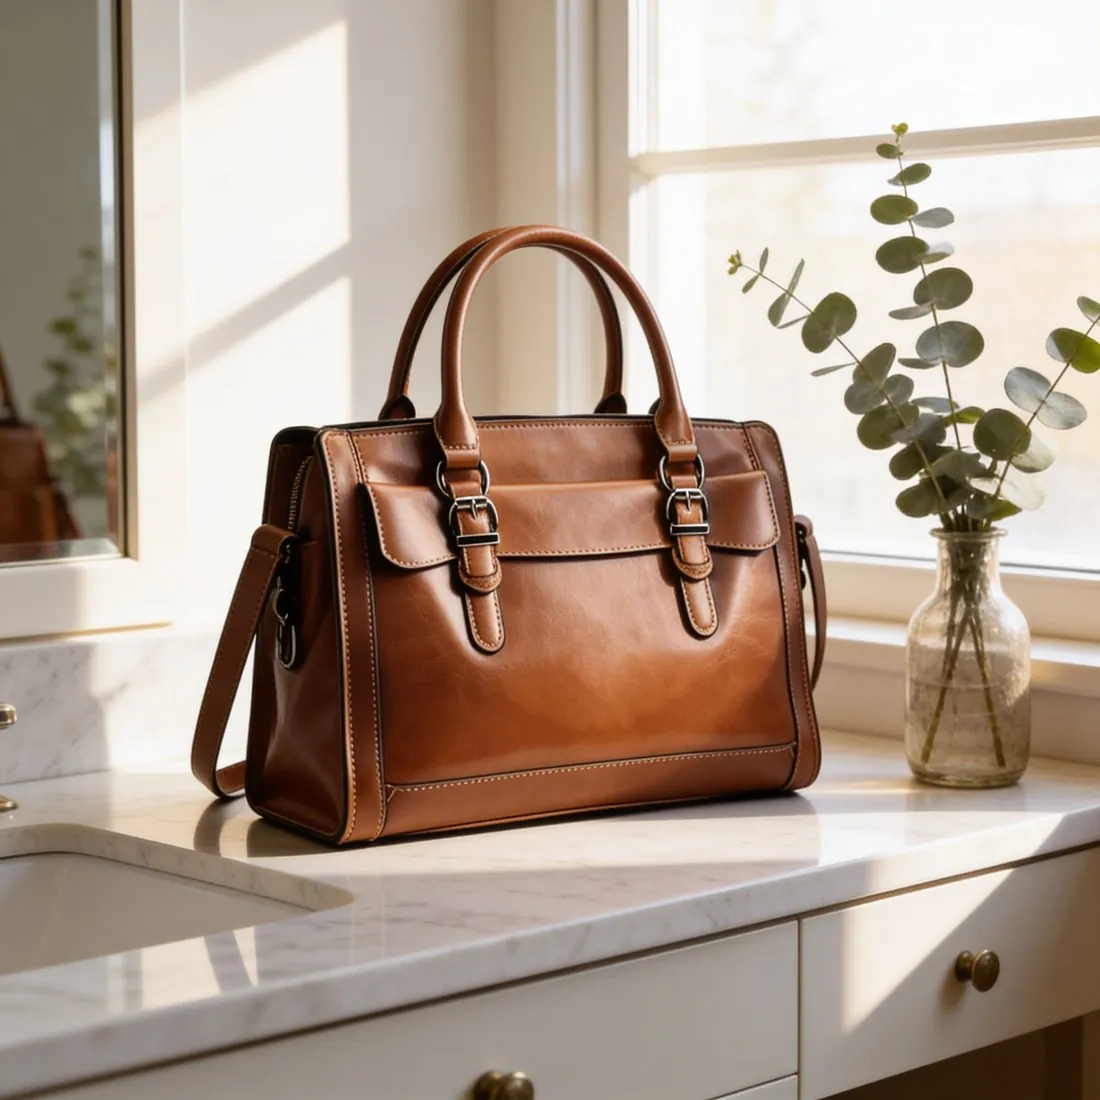
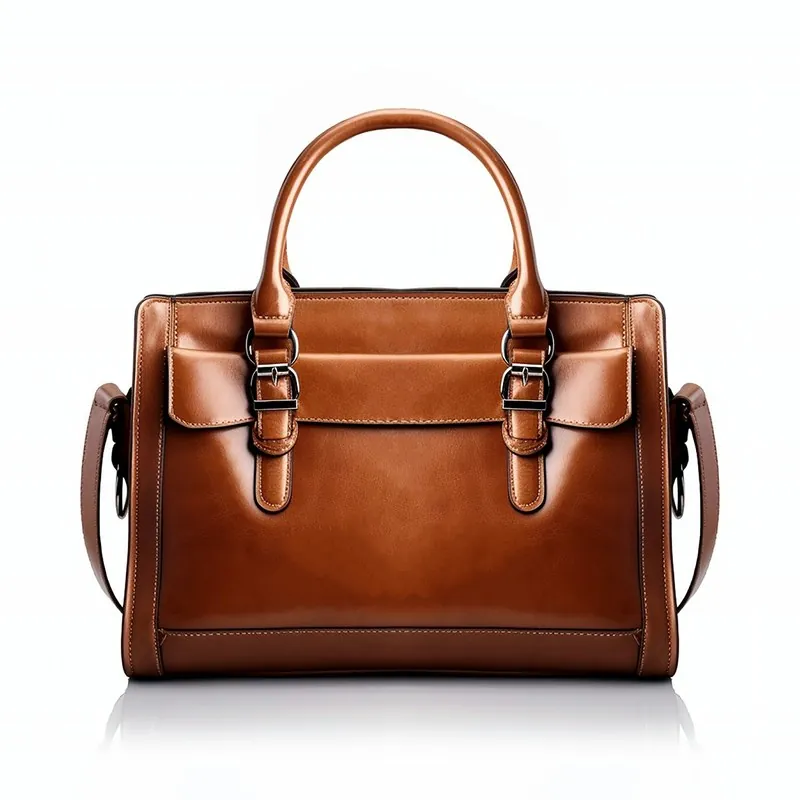
テキストからの画像生成モデルは、言葉をピクセルに変えます。膨大な量の画像とキャプションから、夕暮れの石のテラスに置かれたリネンのシャツといった言い回しが通常どう見えるかを学習しており、説明に合う新しい画像を描きます。結果は配置としては新しいものですが、特定の物ではなくパターンから組み立てられています。そのため、ありそうなシャツは描けても、出品者のシャツは描けません。
これが商品画像における根本的な限界です。テキストだけから生成した商品は作り物で、シルエット、色、柄、金具、ラベルが実物と異なり、どれほど似て見えても出品でその品物の代わりにはなりません。多くのマーケットプレイスは画像に実際の商品を写すことを求めており、AI の使用を、実物の商品写真の周りの背景、場面、モデルに限って認めるところもいくつかあります。AI画像の開示や表示に関する規定も、マーケットプレイスによって異なります。
テキストからの画像生成が向いているのは、唯一の正しい形を持たないものです。背景、小道具、雰囲気を伝える場面、テクスチャや柄、キャンペーン用のセットなどです。商品そのものについて確実なのは、実物の写真を出発点とする画像からの画像生成です。生成した場面を実物の商品の切り抜き画像の背景にする場合は、光の向き、影、遠近を商品写真に合わせなければ、商品が貼り付けたように見えます。