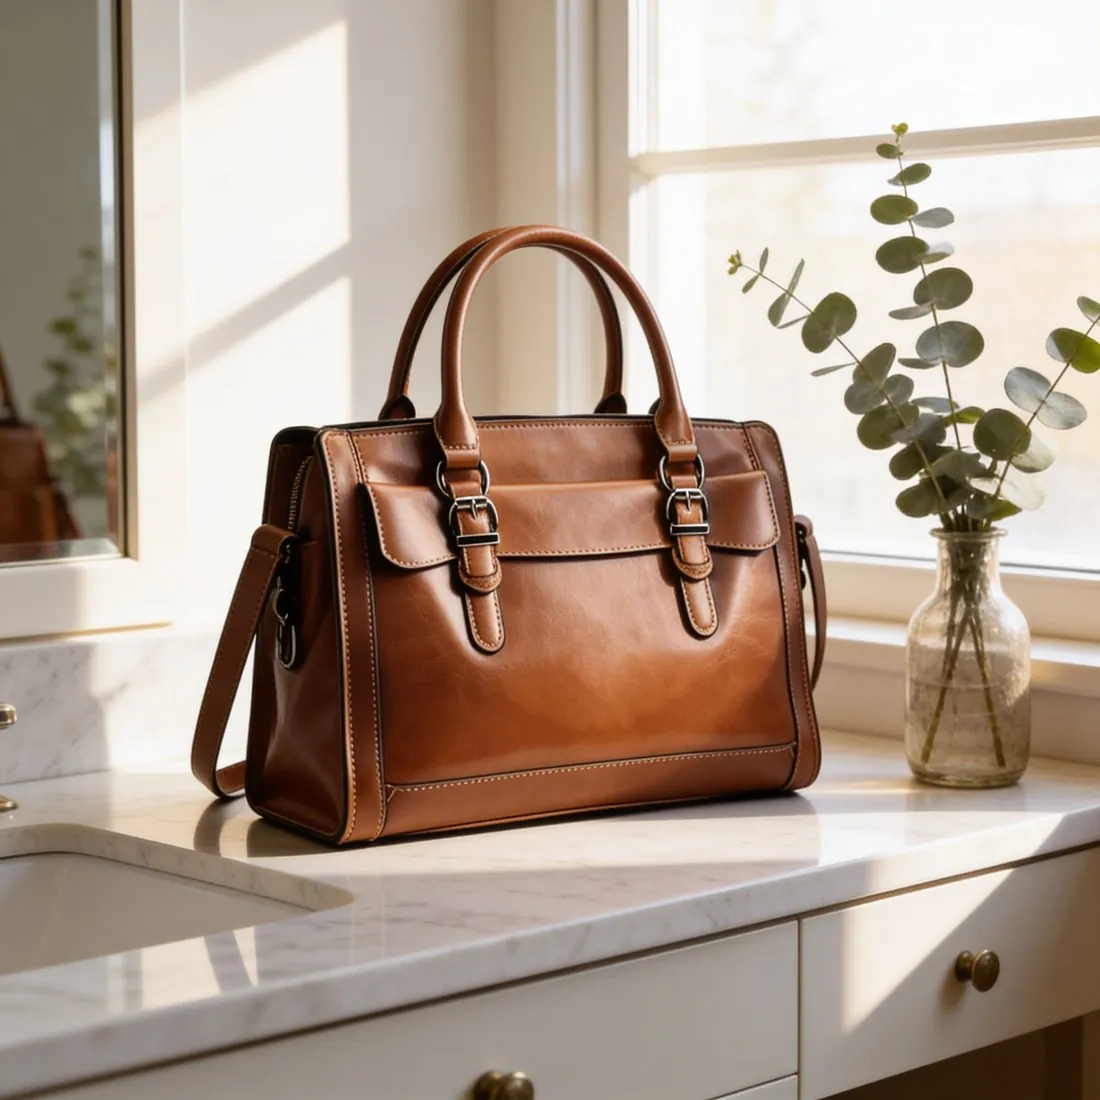
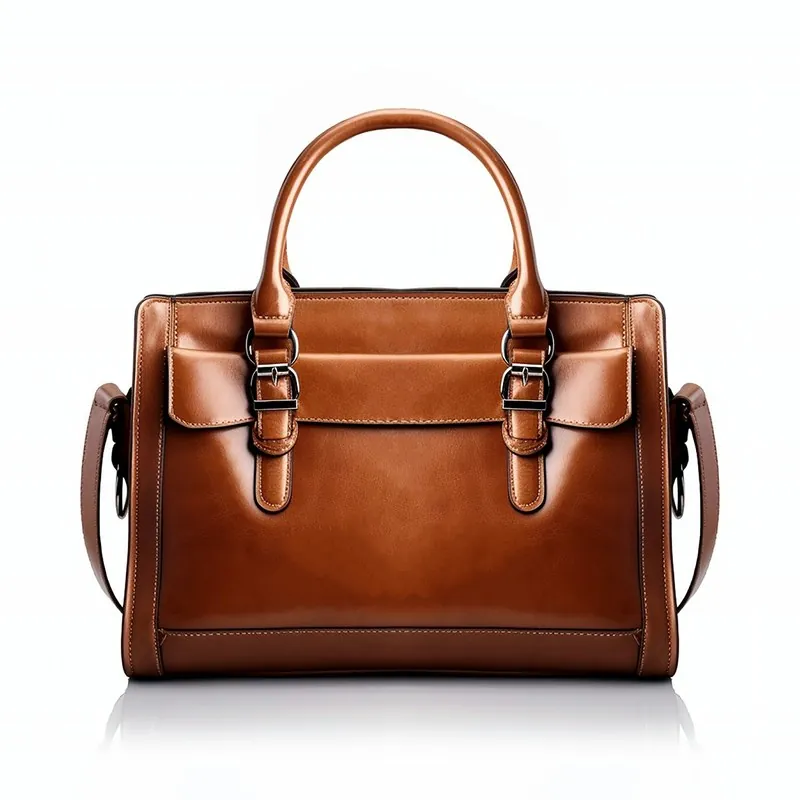
Un modèle text-to-image transforme des mots en pixels. Il a appris, à partir de très grandes collections d’images et de légendes, à quoi ressemble d’ordinaire une formule comme une chemise en lin sur une terrasse de pierre au crépuscule, et il dessine une nouvelle image conforme à la description. Le résultat est nouveau dans sa composition mais construit à partir de schémas, non d’un objet particulier : il peut montrer une chemise plausible, mais pas la chemise du vendeur.
C’est la limite centrale pour les images produit. Un produit généré à partir du seul texte est inventé : il diffère de l’article réel par la coupe, la couleur, le motif, les accessoires métalliques et l’étiquette, et il ne peut pas représenter cet article dans une annonce, aussi ressemblant soit-il. Beaucoup de marketplaces exigent que les images montrent le produit réel, et plusieurs n’autorisent l’IA que pour les fonds, les décors ou les modèles autour d’une vraie photo produit. Les règles de divulgation et de signalement des images IA diffèrent aussi d’une marketplace à l’autre.
Le text-to-image convient à ce qui n’a pas de forme vraie unique : fonds, accessoires de décor, scènes d’ambiance, textures et motifs, ou décor pour une campagne. Pour le produit lui-même, la voie fiable est l’image-to-image, où une photo de l’article réel sert de point de départ. Lorsqu’une scène générée sert de fond à une image détourée du produit réel, la direction de la lumière, les ombres et la perspective doivent correspondre à la photo produit, sinon le produit paraît collé.