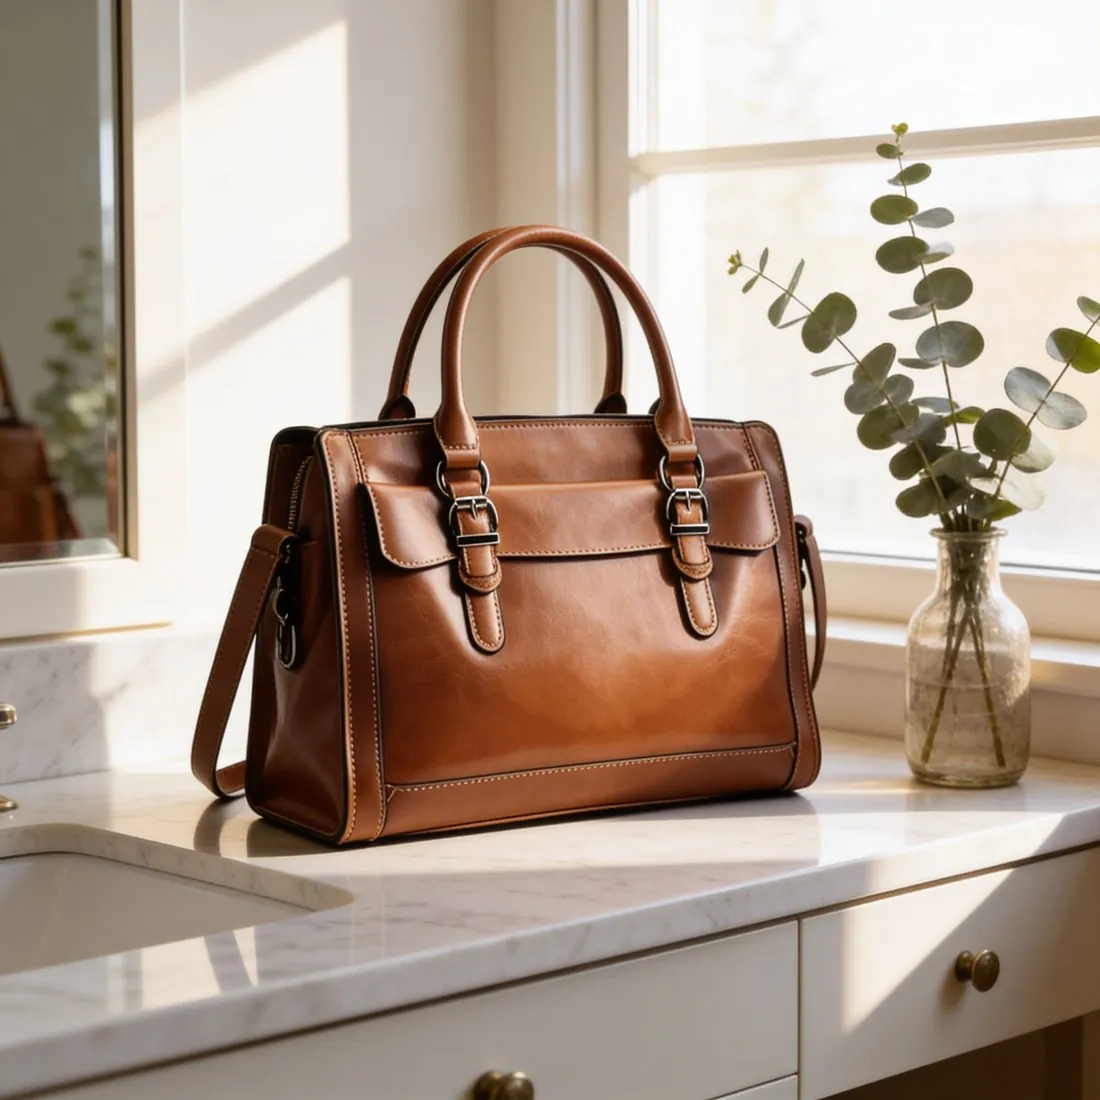
Model text-to-image zamienia słowa w piksele. Z bardzo dużych zbiorów obrazów i podpisów nauczył się, jak zwykle wygląda opis taki jak lniana koszula na kamiennym tarasie o zmierzchu, i rysuje nowy obraz pasujący do opisu. Wynik jest nowy w swoim układzie, ale zbudowany ze wzorców, a nie z konkretnego przedmiotu, więc może pokazać wiarygodną koszulę, ale nie koszulę sprzedawcy.
To podstawowe ograniczenie przy zdjęciach produktów. Produkt wygenerowany wyłącznie z tekstu jest wymyślony: różni się od prawdziwego przedmiotu krojem, kolorem, wzorem, okuciami i metką i nie może reprezentować tego przedmiotu w ofercie, choćby wyglądał bardzo podobnie. Wiele marketplace’ów wymaga, by zdjęcia pokazywały rzeczywisty produkt, a kilka dopuszcza AI tylko w tłach, scenach lub modelach wokół prawdziwego zdjęcia produktu. Zasady ujawniania i oznaczania obrazów AI również różnią się między marketplace’ami.
Generowanie z tekstu pasuje do tego, co nie ma jednej prawdziwej formy: teł, rekwizytów, scen nastrojowych, faktur i wzorów albo scenografii do kampanii. Dla samego produktu niezawodną drogą jest generowanie obrazu z obrazu, gdzie punktem wyjścia jest zdjęcie prawdziwego przedmiotu. Gdy wygenerowana scena służy jako tło dla wycięcia prawdziwego produktu, kierunek światła, cienie i perspektywa muszą pasować do zdjęcia produktu, inaczej produkt wygląda na wklejony.