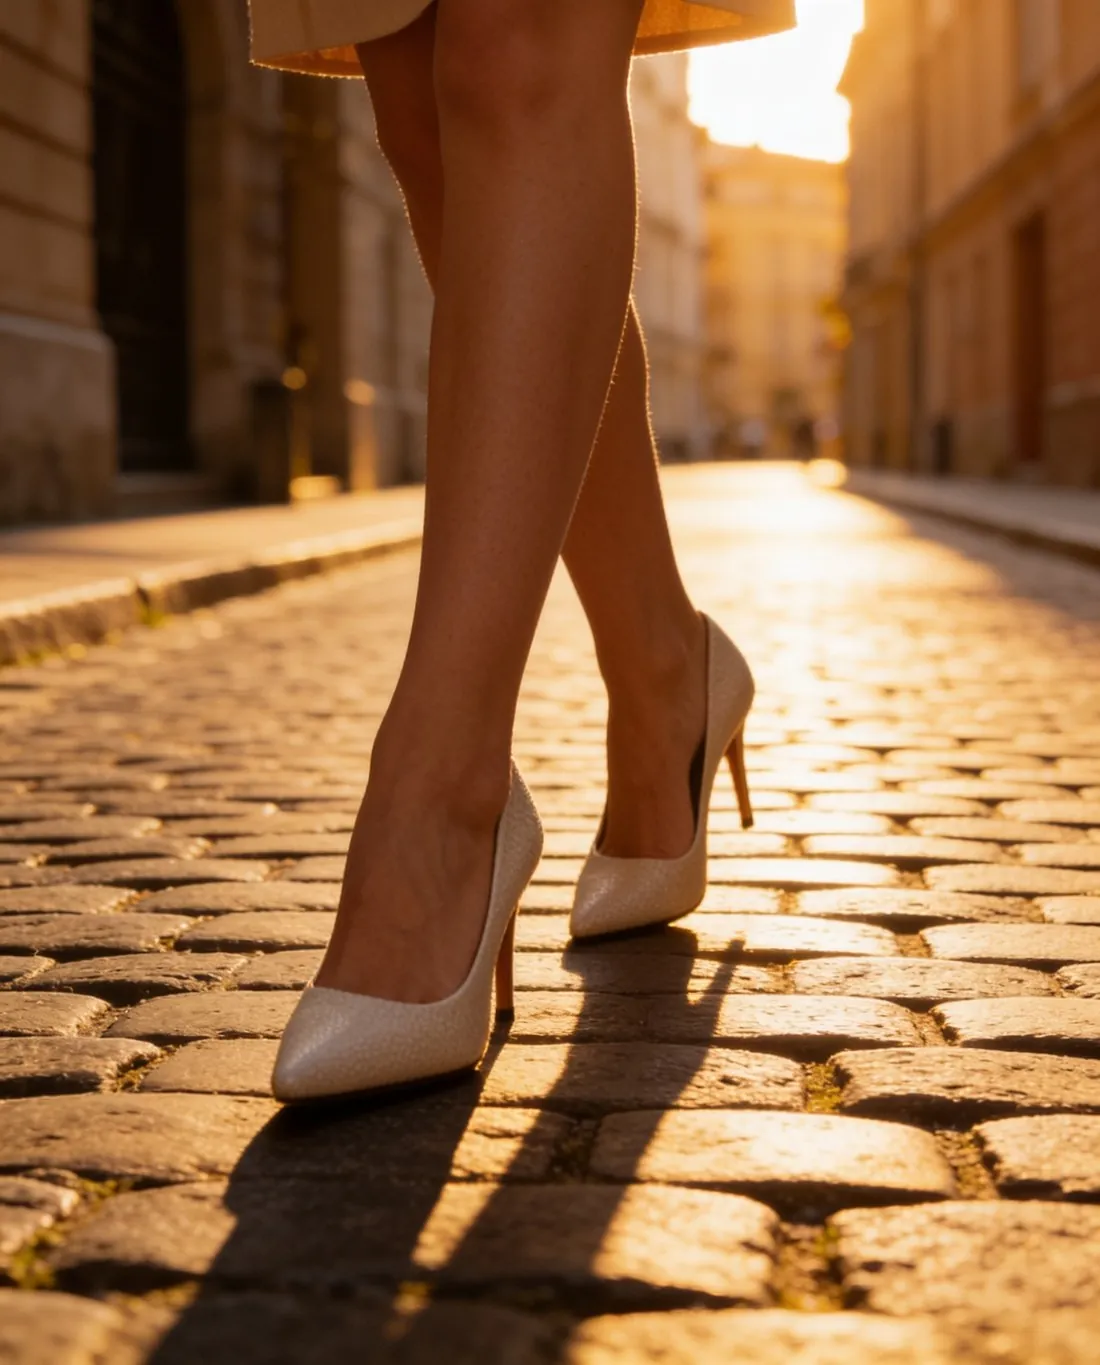
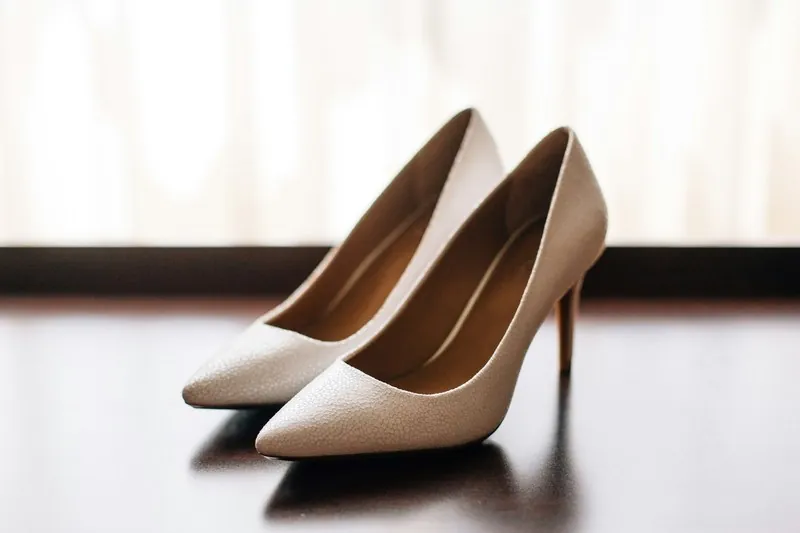
画像からの画像生成では、モデルはプロンプトに加えて画像を受け取ります。手法によって、元画像が固定するのは構図であったり、被写体であったり、スタイルだけであったりし、強度の設定が、結果が元画像からどこまで離れてよいかを決めます。出品者にとって役立つのは、商品写真を軸にする形です。衣料品、バッグ、靴が被写体のまま、背景、モデル、光が変わります。
結果の頼りになる情報は元画像が持っています。ぼやけたスマートフォンの写真、しわくちゃの衣料品、色かぶりは、そのまま引き継がれるか、推測で補われます。商品全体を正面からまっすぐ、均一な光で写したシャープな写真なら、モデルが作り出さなければならない部分が最小になります。ジャケットの背面やバッグの内側など、元画像に写っていない部分は作り出すしかなく、誤りが現れるのはそこです。
よい元画像からであっても、出力は元のピクセルではなく、商品を新しく描き直したものです。強度の設定を高くするほど、モデルは自由に描き直します。まず場面が変わり、次に色と質感がずれ、さらにステッチの線、ポケットの形、プリントの位置といった作りが変わります。強度を低くすれば元画像に近くなりますが、その欠点も残るため、いくつかの結果を実物と比べて設定を決めます。AI画像を受け付けるマーケットプレイスは、商品を正確に表すことを求めており、表示の規定はマーケットプレイスによって異なります。